10. 프로젝트 회고: 멀티모달 AI 서비스에서 배운 것
프로젝트 : SeSAC:Note 영상 요약 AI 서비스
역할 : AI & Backend Infrastructure
기간 : 2025.11.28 ~ 2026.02.11 (약 2.5개월)
기여 : 커밋 198개 (Backend/AI/Infra 주도)
나는 내 학습 목표를 달성하기 위해 무엇을 어떻게 했는가?
학습 목표 달성을 위해 대용량 영상 처리 파이프라인 최적화와 안정적인 백엔드 서비스 구축에 집중했습니다.
[목표 1] AI/LLM 파이프라인 구축 및 최적화
영상 요약 비용을 줄이고 응답 속도를 개선하기 위해 캡처 로직과 병렬 처리 파이프라인을 설계했습니다.
영상 전처리 및 알고리즘 최적화
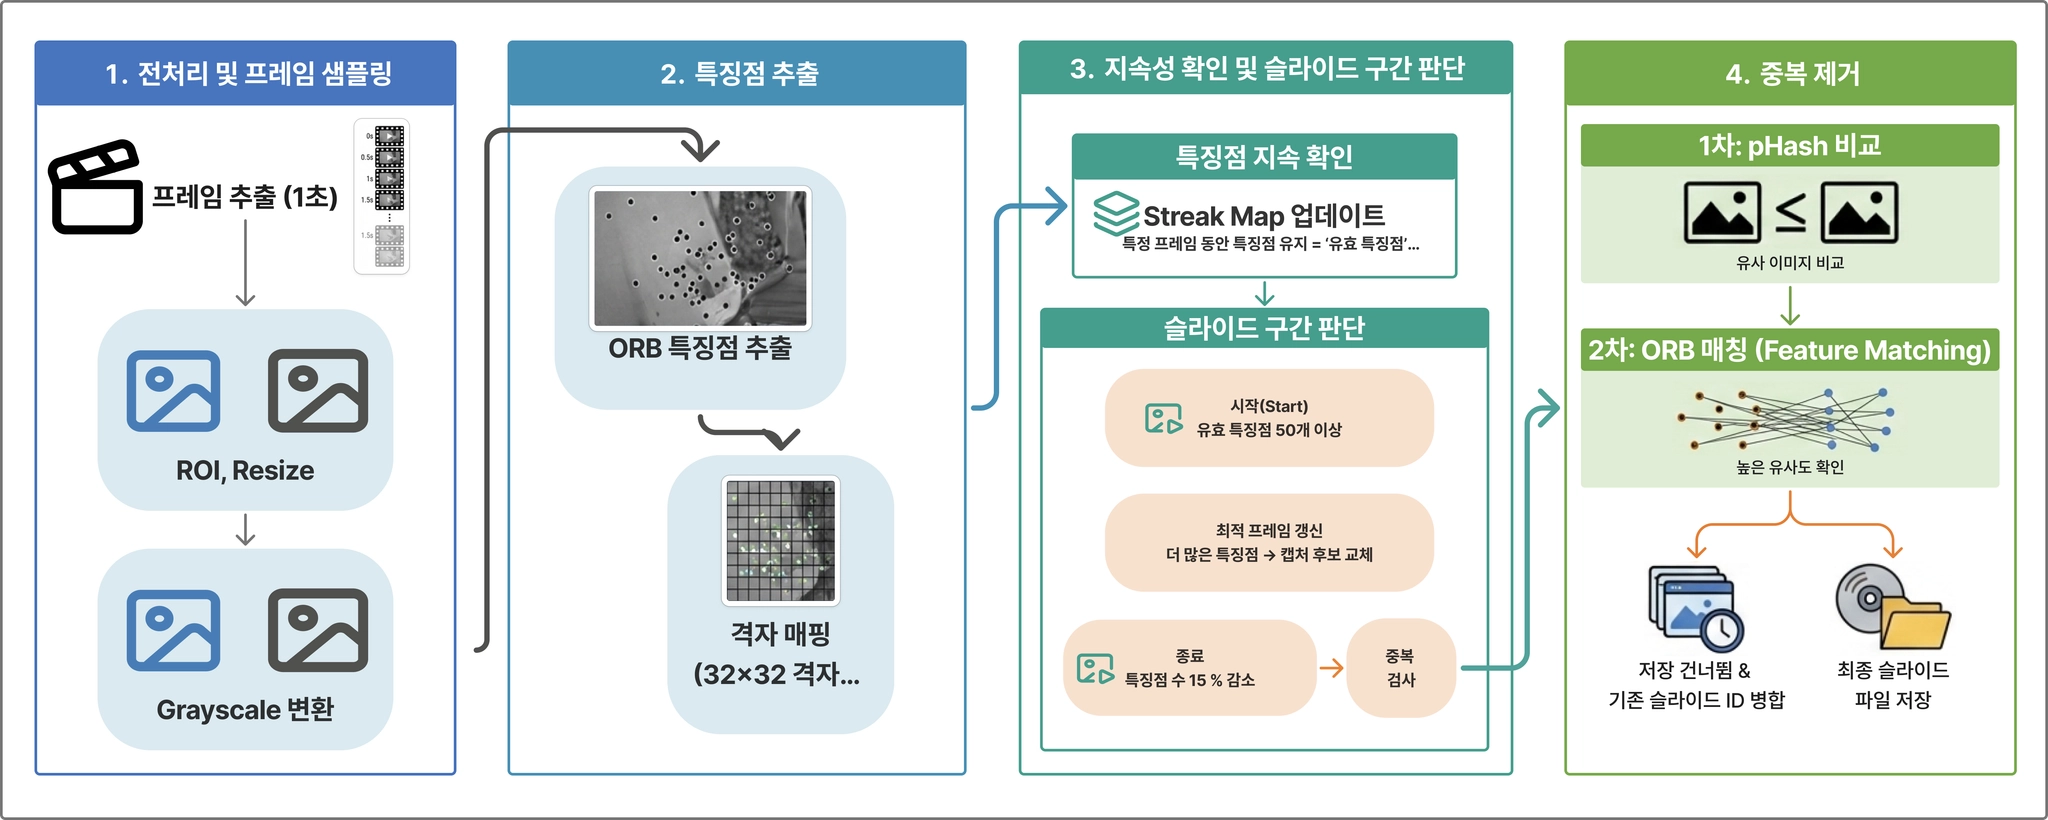
ORB 알고리즘 기반으로 프레임 간 특징점을 비교하여 중복 프레임을 제거했습니다. ROI(관심 영역) 감지 후 리사이징된 이미지의 pHash 값을 비교하고, 유사한 프레임들을 타임라인상에서 병합하여 불필요한 VLM 호출 횟수를 줄였습니다.
비동기 파이프라인 아키텍처
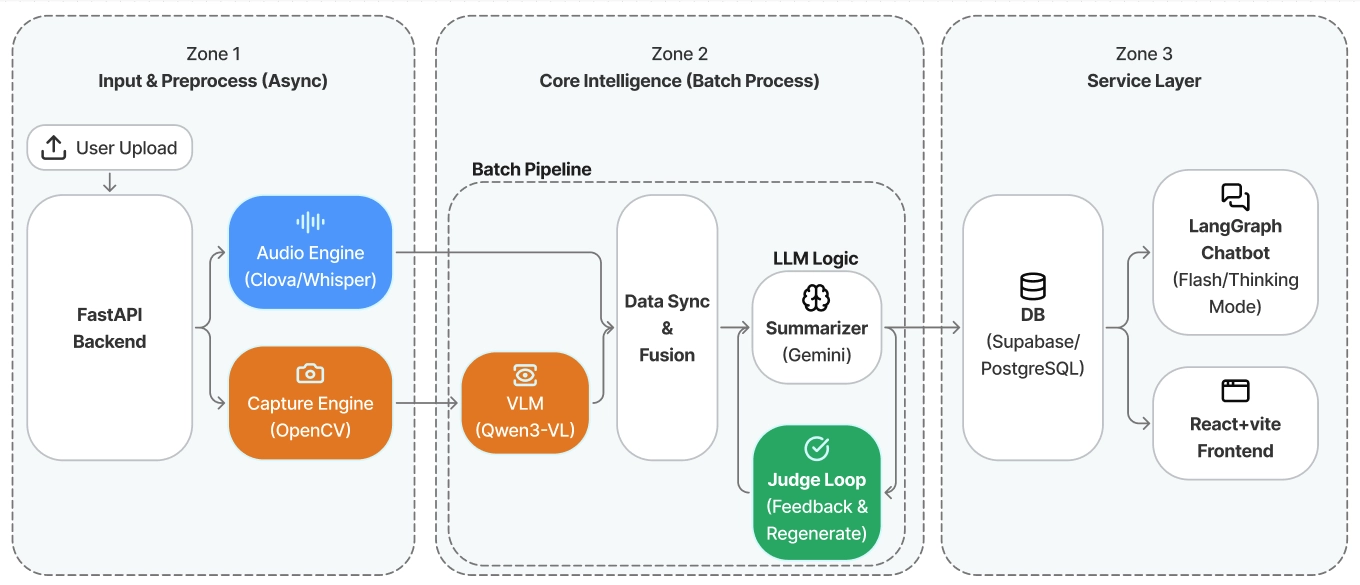
전체 처리 시간을 단축하기 위해 STT 추출(Clova API), 프레임 캡처, 오디오 추출 작업을 병렬로 수행하도록 구현했습니다. 각 작업이 완료된 후 데이터를 동기화하고, 이후 요약 생성 단계는 비동기적으로 처리하여 사용자 대기 시간을 최소화했습니다.
Judge 시스템 경량화 및 고도화
기존 Judge가 수행하던 데이터 정합성 검증은 시스템 레벨로 이관하고, Judge는 요약의 형식과 정보 품질 검수에만 집중하도록 역할을 분리했습니다.
VLM/Summarizer 모델 실험
한국어와 영어, JSON과 JSONL 포맷 등 4가지 조합에 대한 비교 실험을 진행하여 최적의 프롬프트를 도출했습니다.
시스템 안정성 강화
복잡했던 라우팅 로직을 간소화하여 실행 흐름을 명확히 하고, API 호출 실패 시 재시도 로직을 적용해 안정성을 높였습니다.
[목표 2] 백엔드 및 인프라 엔지니어링
데이터의 무결성을 보장하고 서비스 확장성을 고려하여 스토리지와 데이터베이스를 구성했습니다.
RDBMS 도입 및 스키마 설계
영상 메타데이터와 요약 결과의 관계를 명확히 정의하기 위해 PostgreSQL을 도입했습니다. 초기 스키마를 구성하고 저장소를 연동하여 데이터의 구조적 안정성을 확보했습니다.
Object Storage 마이그레이션
초기에는 로컬 파일 시스템을 사용했으나, 영상 데이터의 용량 증가와 배포 확장성을 고려하여 Cloudflare R2 스토리지로 마이그레이션을 진행했습니다.
[목표 3] 협업 프로세스 및 문서화
팀 내 기술적 의사결정을 주도하고 이슈 기반의 개발 프로세스를 정착시켰습니다.
데이터 기반 의사결정
VLM 및 Judge 모델의 벤치마크 결과를 이슈로 문서화하여 공유함으로써, 팀원들이 객관적인 데이터에 기반해 의사결정을 내릴 수 있도록 지원했습니다
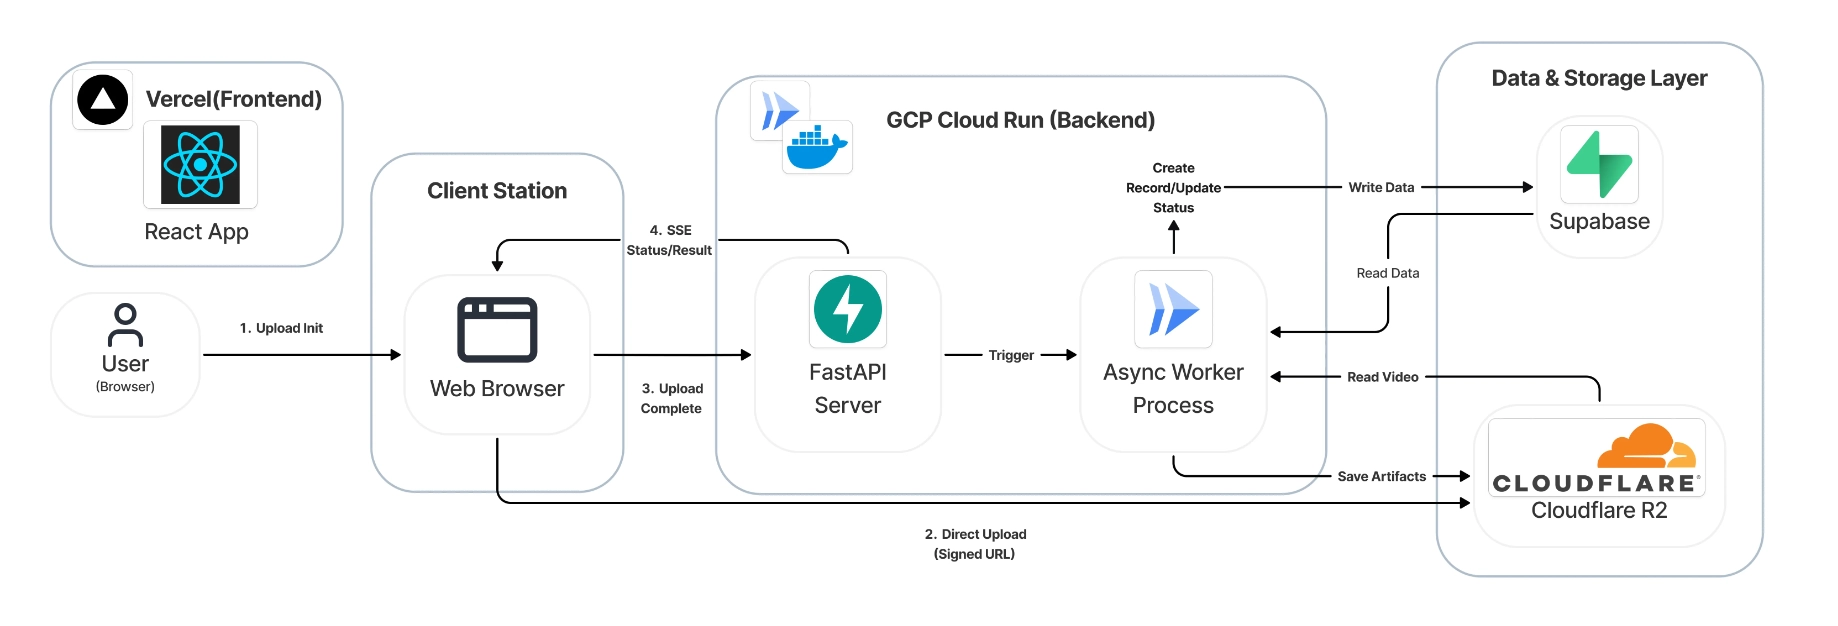
DevOps 및 인프라 환경을 직접 구축한 것도 큰 변화입니다. 로컬 개발 환경에 머무르지 않고 Docker 컨테이너화, Cloud Run 배포, R2 스토리지 연동까지 직접 수행했습니다. 배포 과정을 자동화함으로써 반복 작업을 줄이고 스토리지 확장성을 확보했습니다.
체계적인 Issue/PR 관리 사이클을 도입했습니다. 단순 구현에 그치지 않고 ‘Issue 등록 → PR 작성 → Code Review → Merge → Close’로 이어지는 전체 사이클을 준수했습니다. 이로 인해 버그 발생 원인과 해결 과정을 투명하게 추적하고 관리할 수 있었습니다.
마주한 한계는 무엇이며, 아쉬웠던 점은 무엇인가?
가장 큰 기술적 한계는 캡처 로직의 민감도 문제였습니다. 정적인 영상(슬라이드 중심)에서는 구현한 ORB 기반의 특징점 비교 로직이 효과적으로 작동했으나, 화면 전환이 잦거나 동적인 요소가 많은 영상에서는 변화를 너무 민감하게 감지했습니다. 이로 인해 불필요한 프레임이 과도하게 캡처되는 문제가 발생했고, 이는 VLM 호출 비용 증가로 이어질 수 있었습니다.
처리 속도와 운영상의 한계
- 속도(Latency) 문제
전체 처리 시간이 길어 사용자 경험 측면에서 개선 필요성이 확인되었다.
- 품질 확보를 위한 외부 API 의존
요약 품질과 안정성을 높이기 위해 상용/외부 API 기반의 모델 호출을 사용했다. 이 방식은 빠른 프로토타이핑에는 유리했지만, 비용·쿼터·네트워크·키 장애 등 운영 리스크가 존재하며, 장기적으로는 자체 서빙 전환도 고려해 봐야 한다.
- 모델 서빙 경험 부재
이번 프로젝트에서는 모델을 직접 서빙하는 운영 경험(AWS/GCP 기반 배포, 스케일링, 모니터링, 비용 최적화 등)을 충분히 수행하지 못했다. 결과적으로 서비스 관점의 End-to-End 운영 역량까지는 검증이 제한적이었다.
- 판서 중심 강의 처리 미흡
현재 파이프라인은 ‘슬라이드 기반 강의’를 전제로 설계되어 있어, 판서(화이트보드/태블릿 필기) 중심 강의에서 발생하는 점진적 변화, 손글씨 인식, 지우기/덧쓰기 등 시각적 특성을 충분히 처리하지 못했다.
한계/교훈을 바탕으로 다음 프로젝트에서 시도해보고 싶은 점은 무엇인가?
이번 프로젝트에서 겪은 캡처 로직의 한계를 개선하고, LLM 활용 범위를 확장하는 방향으로 발전시켜보고 싶습니다.
콘텐츠 분류 모델 도입
캡처 로직 실행 전, 영상의 종류(정적/동적)를 분류하는 모델을 배치하고자 합니다. 각 영상 특성에 최적화된 로직을 개별적으로 적용한다면 ‘민감도 문제’를 해결할 수 있을 것입니다.
일반화 캡처 알고리즘 연구
특정 상황에 구애받지 않고 다양한 영상 환경에서 안정적으로 동작하는, 일반화 성능이 뛰어난 캡처 알고리즘을 지속적으로 탐구해보고 싶습니다.
Agent Orchestration 및 보안 검증
단순한 프롬프트 최적화를 넘어, 에이전트 오케스트레이팅을 통해 시스템의 보안 취약점이나 최적화 요소를 스스로 검증하는 구조를 만들어보고 싶습니다. 또한 AOP(Auto Optimize Prompt) 기법을 활용해 최적의 프롬프트를 자동으로 탐색하는 시스템을 구축해보고 싶습니다.
서비스 운영과 판서 처리의 후속 과제
다음 항목은 개발 과정에서 정리한 후속 계획이며, 이 프로젝트에서 완료한 성과를 뜻하지 않습니다.
- 속도 개선
- DB/스토리지 아키텍처 재설계(Supabase 의존도 축소)
- Supabase 중심 구조에서 벗어나, 운영 요구사항에 맞게 DB/스토리지를 분리·이관하는 방안을 검토한다.
- 예: PostgreSQL 자체 운영(RDS/GCP Cloud SQL), Object Storage(S3/GCS)로 분리하여 성능/비용/확장성을 최적화
- 실행 이력(run/batch/segment) 관리와 관측성(로그/메트릭)을 강화해 대규모 처리에도 안정적으로 운영 가능한 형태로 확장한다.
- 모델 서빙(AWS/GCP) 실전 적용
- AWS 또는 GCP에서 VLM/LLM(또는 일부 경량 모델)의 서빙 파이프라인을 직접 구축해, API 의존도를 단계적으로 낮춘다.
- 컨테이너 기반 배포(Docker), 오토 스케일링, GPU 인스턴스 운영, 모니터링/알람을 포함한 “서비스 운영 루프”를 실제로 경험하고 최적화한다.
- 판서 처리 기능 추가
- 판서 강의 특성에 맞게 “점진적 변화 감지” 및 “필기 누적 캡처” 로직을 별도로 설계한다.
- 손글씨/수식 인식(OCR/수식 인식)과 결합하여 판서 내용을 구조화하고, 슬라이드 기반 파이프라인과 동일하게 STT 시간축 정렬 → 근거 기반 요약으로 연결한다.
- 결과적으로 슬라이드/판서 혼합 강의까지 범용적으로 대응 가능한 멀티모달 노트 생성기로 확장한다.