06. 캡처와 VLM 개선: 중복 슬라이드와 입력 품질 다루기
SeSAC:Note에서 화면 정보는 요약 품질의 출발점입니다. 캡처가 중복되면 VLM 비용이 늘고, 캡처가 부정확하면 STT와 화면의 연결이 흔들립니다. VLM 입력이 나쁘면 Summarizer와 Judge까지 영향을 받습니다.
이 글은 개발 과정에서 정리한 CV/VLM 개선 흐름입니다. 핵심은 “모든 프레임을 많이 넣자”가 아니라, “의미 있는 화면만 안정적으로 추출하고, VLM이 요약에 쓰기 좋은 구조로 출력하게 만들자”였습니다.
문제: 동일 슬라이드 반복 캡처와 VLM 비용 증가
초기 캡처는 화면 변화 감지에 집중했습니다. 하지만 강의 영상에서는 같은 슬라이드가 오래 유지되거나, 포인터와 작은 애니메이션만 바뀌는 경우가 많습니다. 이런 장면을 모두 저장하면 실제로는 같은 슬라이드인데 VLM에는 여러 장의 이미지가 들어갑니다.
문제는 두 가지였습니다.
| 문제 | 영향 |
|---|---|
| 동일 슬라이드 반복 캡처 | VLM 호출량과 저장량 증가 |
| 유사 프레임 연속 저장 | timestamp와 slide timeline 품질 저하 |
프로젝트 기록 기준으로 pHash+ORB 중복 제거를 추가한 뒤 VLM 호출량을 약 50% 줄이는 방향의 개선이 정리되어 있습니다. 이 수치는 해당 실험 조건에서의 기록이며, 모든 영상에서 동일하게 보장되는 값은 아닙니다.
특징점 추적과 중복 슬라이드 병합
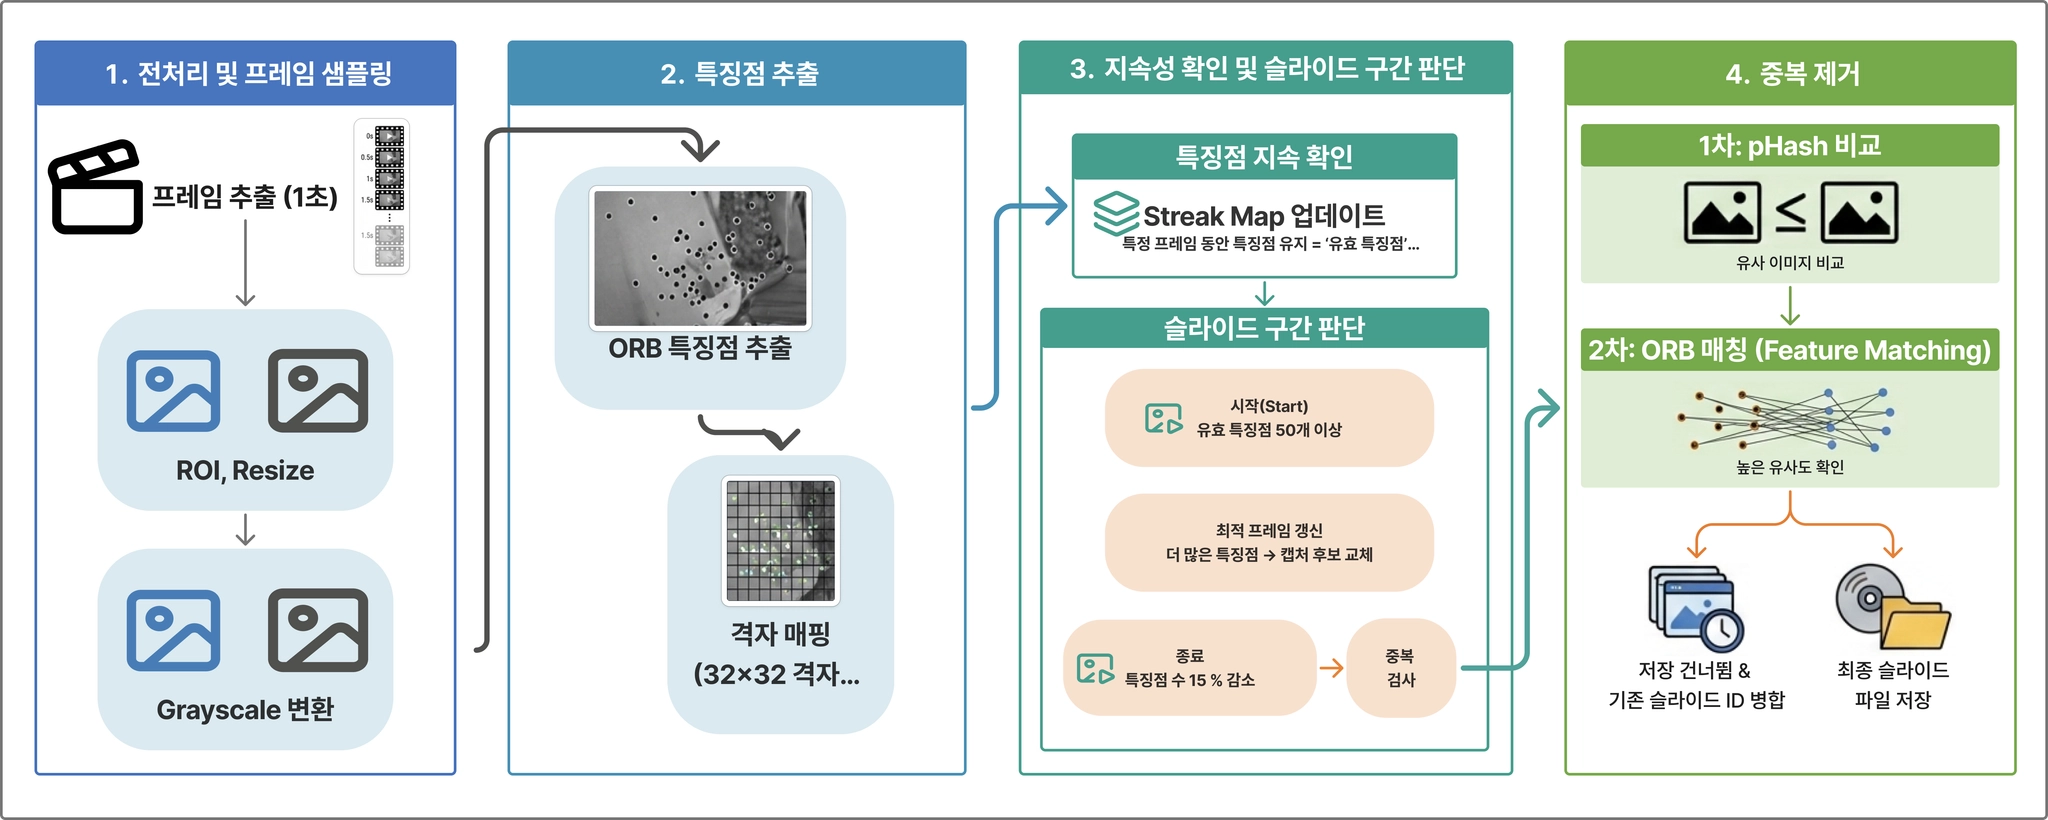
전환을 감지하는 일과 이미 저장한 슬라이드를 다시 판별하는 일을 나눴습니다. 특징점 추적과 대표 프레임 선택, 중복 병합의 구현 기준은 다음과 같습니다.
Slide Extraction Engine: (hybrid_extractor.py ):
- 배경 정보 차단 : 대부분의 픽셀을 차지하는 배경을 배제하기 위해, 모서리 등의 유의미한 시각적 특징만 추출하여 실제 정보에 집중
- 유효 정보 탐지: 추출된 특징점이
persistence_threshold(10회, 총 5초) 이상 동일 좌표에 고정될 때만 유효 특징점으로 확정하여, 일시적인 움직임과 정적인 슬라이드 및 글자 정보를 정밀하게 구분
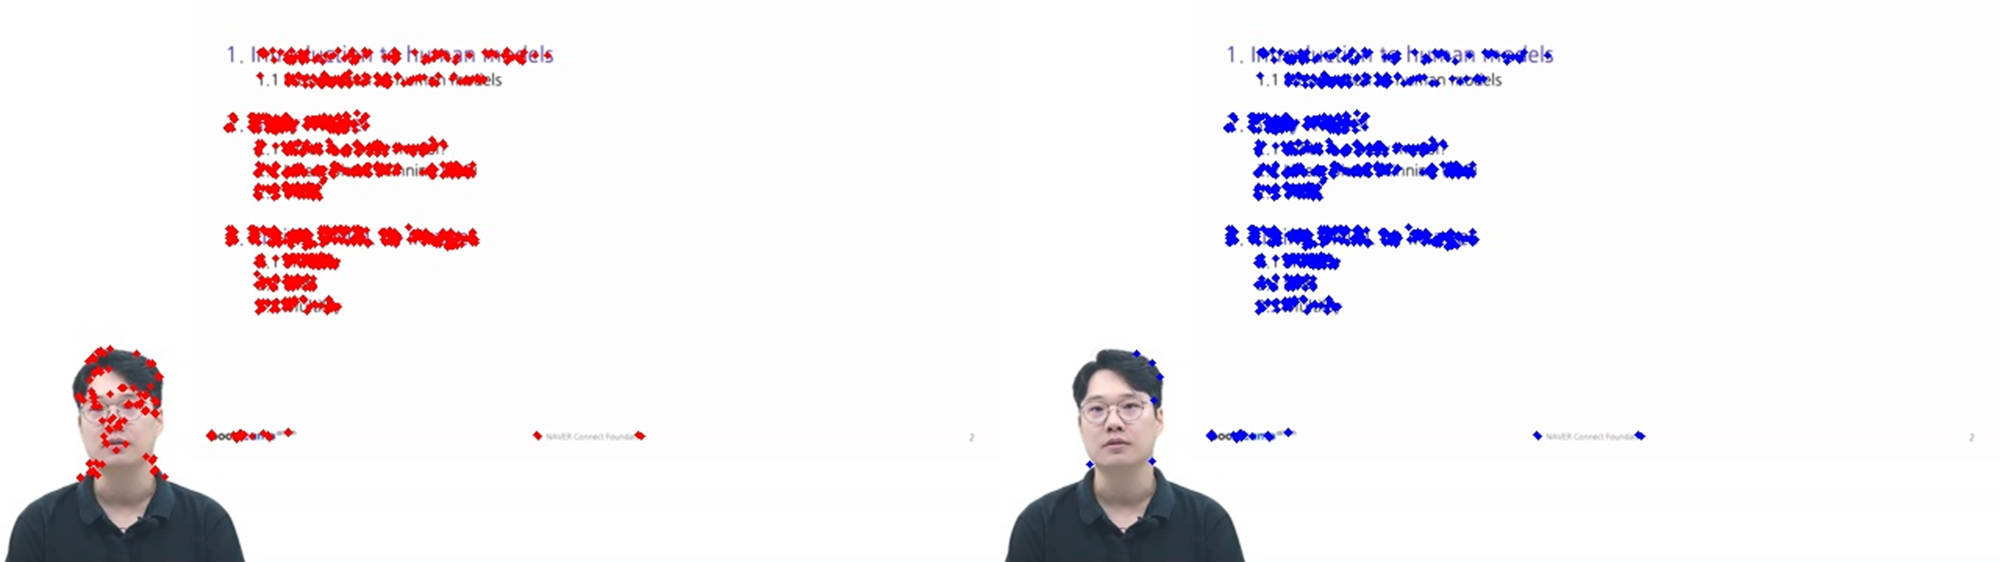
(좌측 : orb로 추출한 특이점, 우측 : 정적으로 유지되는 특이점)
- 슬라이드 분할: 유효 특징점의 개수가 급격히 감소하는 지점을 슬라이드 전환의 임계점으로 판단. 이를 통해 화면 일부만 변하는 환경에서도 명확한 분할 경계를 식별
- 유효 특징점 개수가
min_orb_features(기본 50개)를 넘어서는 순간 캡처 후보로 등록. - 유효 특징점 개수가 기준치 대비
persistence_drop_ratio(기본 70%) 이상 급감하면 슬라이드 종료로 간주하고 저장 프로세스를 실행.
- 유효 특징점 개수가
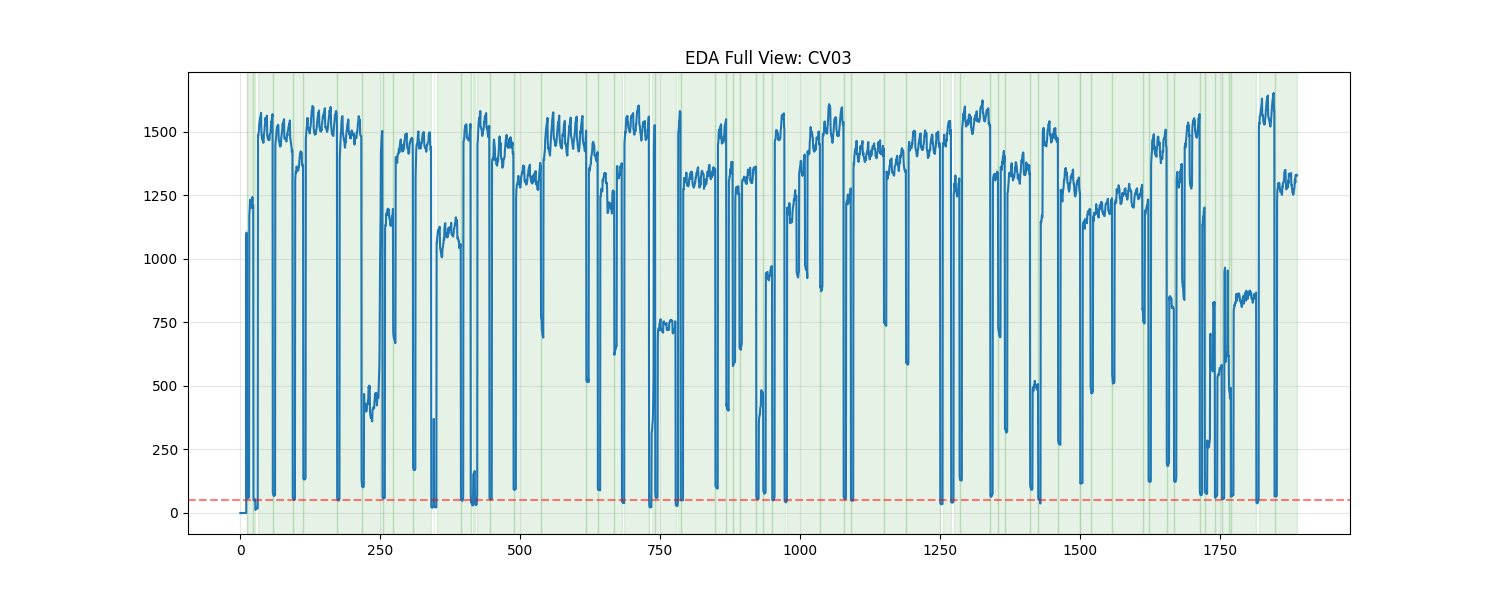
- 최적 프레임 선별: 슬라이드 구간 내에서 특징점 수가 정점에 도달하는 순간을 포착하여, 글자가 가장 많이 채워진 프레임을 추출.
- 같은 슬라이드로 판단되는 동안, 더 선명/정보량이 많은(특징점이 더 많은) 프레임이 들어오면 후보 이미지를 교체.
- 중복 제어 : 재등장하는 슬라이드는 하나의 ID로 그룹화하여 스토리지 및 후속 VLM 분석 비용을 최적화.
- 저장 대상 프레임의 pHash와 ORB를 계산.
- 저장된 슬라이드 히스토리(
saved_slides_history)에서 유사 슬라이드를 검색.- 1차 필터: pHash 거리가
dedup_phash_threshold(기본 12) 이하 후보 검색. - 2차 정밀: ORB 매칭 수행. 유사도가
dedup_sim_threshold(기본 70%) 이상이면 중복 확정.
- 1차 필터: pHash 거리가
- 중복 발견 시 파일 저장을 생략하고, 기존 슬라이드 ID에 현재 시간 구간(
time_ranges)만 병합. 신규 슬라이드는 파일 저장 및 새로운 ID 부여.
- 알고리즘 성능 비교: 가장 score가 낮게 나온 영상 기준으로 비교
| 알고리즘 방식 | 처리시간 | 오탐 | 미탐 | F1-score | 비고 |
|---|---|---|---|---|---|
| Pixel Differency (단순 픽셀 변화 기준) | 324s | 13 | 17 | 0.77 | 처리시간이 길고, 미탐이 많아 신뢰도가 낮음 |
| ORB Change (특이점 변화 기준) | 156s | 17 | 3 | 0.86 | 가장 치명적이었던 미탐 문제가 해결 움직임 등에 민감해져 오탐 증가 |
| ORB Drop (고정 특이점 변화 기준) | 126s | 4 | 2 | 0.95 | 움직이는 물체에 대한 강건성이 확보 |
| 최종 알고리즘 (중복제거 적용) | 140s | 2 | 2 | 0.97 | 최종 상용화 모델 선정 |
Manifest Output (JSON)
[
{
"id": "cap_001",
"file_name": "Video_001.jpg",
"time_ranges": [
{ "start_ms": 0, "end_ms": 15000 },
{ "start_ms": 45000, "end_ms": 60000 }
]
}
]
최종 정리
- 특징점 기반 고속 연산: 640x360 (230,400개의 픽셀 데이터) 대신 2,000개 이내의 특징점 좌표 데이터만을 연산 대상으로 삼아 CPU 부하를 대폭 낮추고, 전체 분석 속도를 극대화.
- 최적 정보량 프레임 포착: 슬라이드 유지 구간 내에서 유효한 특징점 수가 최대치에 도달하는 지점을 추적하여, 정보가 가장 많이 채워진 완성본 이미지를 캡쳐.
- 중복 제거:2 stage(pHash, orb매칭)파이프라인, 중복 이미지 저장을 차단하고 데이터를 구조화.
Smart ROI와 adaptive resize
강의 화면 전체가 항상 중요한 것은 아니다. 슬라이드 영역, 코드 영역, 도표 영역처럼 실제 정보가 있는 부분이 중요하다. Smart ROI는 화면 안에서 유효 정보가 있는 영역을 더 잘 잡기 위한 접근이다.
adaptive resize는 VLM 입력 품질과 비용 사이의 균형을 맞추기 위한 장치다. 해상도를 무조건 크게 넣으면 비용과 latency가 늘고, 너무 줄이면 텍스트와 수식이 깨진다. 그래서 화면 특성에 따라 입력 크기를 조정하는 방향이 필요했다.
OCR-first로 VLM 호출을 줄이는 판단
문제 정의
캡처 이미지 1장을 VLM이 처리하는데 평균 7초가 소요되어, 영상 길이가 길어질수록 전체 처리시간이 선형적으로 증가했습니다. 30분 영상 기준 캡쳐 장수가 30~60장, VLM 처리에만 3분에서 7분까지 걸리는 문제가 발생했습니다.
접근 방법
이미 VLM 모델 변경, 프롬프트 경량화 등 최적화를 진행한 상태였기 때문에 VLM에 입력되는 양 자체를 줄이자는 전략을 세웠습니다. 텍스트 화면은 OCR로 대체하고 이미지/도표가 있는 화면만 VLM으로 처리하는 파이프라인을 생각했습니다.
해결
- 1차 분기: Paddle Layout Detection
- 목적: 텍스트만 있는 화면 vs 이미지가 포함된 화면 판별
- 처리시간: 53ms/장
- 텍스트 화면 처리: Paddle OCR
- Text Detection (90ms) + Text Recognition (8ms)
- 최종 처리시간(텍스트 화면 기준)
- VLM 7초(7000ms) → Layout+OCR 162ms
결과
- 텍스트만 있는 슬라이드 처리 시간 7000ms → 162ms로 감소
VLM prompt를 구조화한 이유
문제 정의
화면 정보를 추출하기 위해 VLM을 사용하면서 다음과 같은 문제가 발생했습니다.
- 노이즈 텍스트로 인한 토큰 낭비
- 화면 내 모든 글씨를 그대로 추출하면 페이지 번호, copyright 로고, 소속/워터마크 등이 함께 포함되어 요약 입력 컨텍스트가 불필요하게 커졌습니다. 이런 요소는 제외해라 같은 지시를 프롬프트에 추가해봤지만 성공적으로 제거하지 못했습니다.
- OCR과의 차별성 부족
- 글씨만 뽑으면 결국 OCR과 유사해져, 화면의 구성(레이아웃), 요소 간 연결, 강조(하이라이트) 같은 화면의 맥락이 손실되었습니다.
- 환각이 요약 환각으로 직결
- VLM 출력은 요약 노트의 source 데이터이므로, 여기서의 환각(객체명/수량/정확한 표현 오류)이 그대로 요약 노트 환각으로 이어져 UX에 직접적인 악영향이 있었습니다.
접근 방법
- main/aux 분리 전략
- 텍스트를 강의 내용에 필요한 본문(main)과 메타/노이즈(aux)로 나누어 둘 다 추출하되, one-shot 예시로 어떤 것이 main에 들어가야 하는지 학습시키는 방식으로 안정성을 확보했습니다.
- 결과적으로 노이즈를 aux 카테고리로 격리함으로써 요약 LLM에 불필요한 정보가 들어가지 않도록 했습니다.
- 화면 구조(레이아웃/관계/강조) 추출
- 레이아웃 블록/요소 간 연결/하이라이트를 별도 필드로 추출하도록 schema를 설계했습니다.
- 환각 억제
- 불확실한 경우 추정하지 말고 일반화(예: 강아지 → 동물)하거나 unknown 처리, 고유명사/개체명은 확실하지 않으면 치환, 수량/개체 수는 단정 금지 등의 원칙을 프롬프트에 명시했습니다.
해결
- 출력 포맷을 구조화(JSON 등)하고, 필드를 다음처럼 분리해 문제를 해결했습니다.
- main_text: 강의 요약에 필요한 핵심 텍스트
- aux_text: 페이지 번호/로고/소속/워터마크 등 메타/노이즈 텍스트
- layout: 섹션/블록 단위의 배치 정보(제목/본문/캡션/도표 영역 등)
- relations: 요소 간 연결(예: 도표 ↔ 설명 문장, 항목 ↔ 하위 항목)
- highlights: 강조 표시(색/밑줄/박스 등)와 강조 대상 텍스트
결과
- 노이즈 텍스트가 aux로 격리되어 요약 LLM에 전달되는 컨텍스트 정제
- 불필요 토큰을 줄이고, 요약 모델이 핵심 내용에 더 집중할 수 있어 노트 품질이 개선되었습니다.
- 레이아웃/연결/강조 정보까지 함께 전달되며 요약 노트의 품질 상승
- 요약 노트에서 객체명, 수량 설명의 환각이 감소하여 사용자 UX 개선
프롬프트 버전별 비교
VLM prompt 실험 문서에는 v1.1부터 v2.8까지의 반복 기록이 남아 있다. 아래 수치는 9장 캡처를 대상으로 한 해당 실험 기록 기준이며, 전체 VLM 성능이나 모든 영상 처리 속도를 의미하지 않는다.
| 버전 | 총 VLM 시간 | 평균 시간/장 | v1.1 대비 | 기록된 해석 |
|---|---|---|---|---|
| v1.1 | 23.87초 | 2.7초 | 1.00x | 빠르지만 출력 구조가 단순함 |
| v2.2 | 36.74초 | 4.1초 | 1.54x | Main/Aux/Visual Evidence 분리 기준 도입 |
| v2.3 | 36.34초 | 4.0초 | 1.52x | 압축과 구조 안정성의 균형을 확인 |
| v2.4 | 30.76초 | 3.4초 | 1.29x | 구조는 유지하면서 응답 시간 감소 |
| v2.5 | 32.33초 | 3.6초 | 1.35x | 추가 압축에도 응답 시간은 비선형 |
| v2.6 | 32.60초 | 3.6초 | 1.37x | 객체 오인식 위험 관찰 |
| v2.7 | 41.38초 | 4.6초 | 1.73x | 오인식 위험과 응답 시간 증가 관찰 |
| v2.8 | 25.37초 | 2.8초 | 1.06x | 후보 격리와 one-shot 예시로 출력 일관성 개선 |
이 표에서 중요한 점은 “가장 긴 prompt가 항상 느리고, 가장 짧은 prompt가 항상 좋다”가 아니라는 것이다. v2.8은 v1.1과 가까운 응답 시간을 유지하면서도 Main Text, Auxiliary Text, Visual Evidence를 분리하고, 불확실한 객체는 후보 표현으로 격리하는 방향을 확인한 실험이다.
따라서 공개적으로 말할 수 있는 결론은 제한적이다. VLM prompt 실험은 정량 성능 일반화의 근거가 아니라, 요약 입력으로 들어가는 화면 정보를 더 구분 가능하게 만들고 입력 노이즈를 낮추려는 개선 기록이다.
VLM 호출과 출력 결합 구현
VLM Engine: vlm_engine.py
- Alibaba Cloud의 API를 통해 VLM 모델 qwen/qwen3-vl-32b-instruct를 사용해 이미지 분석을 수행
- 슬라이드 이미지에서 텍스트/수식/도표 정보를 추출하고, STT와 결합하여 요약 입력 데이터로 활용
- 여러 개의 API key를 환경 변수에 등록하고, 하나의 key가 실패하거나 한도에 도달하면 자동으로 다음 key로 전환되는 Round-robin 로직을 구현
속도 향상을 위해 여러 이미지를 하나의 prompt context로 묶어 처리하는 Batch Mode를 지원
def _build_batch_user_prompt(self, image_count: int) -> str:
"""배치 처리용 사용자 프롬프트를 구성한다."""
return (
"여러 이미지를 순서대로 제공한다. "
f"이미지는 총 {image_count}장이다. "
"각 이미지 결과를 `## Image N` 제목으로 구분해 작성하라. "
"제목은 반드시 `## Image 1`, `## Image 2`처럼 숫자를 붙여 순서대로 출력하고 "
"이미지 수만큼 섹션을 만들어라.\n"
f"{self.user_prompt}"
)
- settings.yaml, prompts.yaml을 이용하여 vlm_engine.py의 프롬프트와 설정을 제어할 수 있도록 구현
VLM Fusion: vlm_fusion.py
- VLM은 캡쳐 이미지 단위로 수행되므로, 시간 정보를 부여하여 STT와의 결합이 필요
- vlm_raw.json(VLM 출력)과 manifest.json(캡쳐 메타데이터)을 결합해 타임스탬프가 포함된 vlm.json을 생성
vlm.json
"items": [
{
"extracted_text": "Main Text\ ...",
"id": "cap_001",
"timestamp_ms": 33
},
    ...
]
- 최종 VLM 결과가 캡쳐 정보와 함께 타임라인 순서대로 정렬되도록 구성
최종 정리
- 안정성: 다중 key 관리 및 에러 핸들링으로 외부 API 의존성 리스크를 최소화
- 성능: Batch + 병렬 요청으로 높은 품질의 VLM 응답을 빠르게 수집하도록 최적화
- 확장성: 설정 파일 분리로 모델/프롬프트 변경 시 코드 수정 없이 대응 가능
시도해 본 것들
- temperature가 1.0으로 높아 토큰 붕괴 현상이 있었고, temperature를 낮춰 안정성을 개선. (Issue #40)
- PaddleOCR는 GPU 서빙이 필수인데 서버 V100의 환경 제약으로 제외함
- GroundingDINO를 활용해 그림/그래프 위치를 찾아 전달하는 방안을 실험했으나, 모델 수 증가 대비 효과가 제한적이라 중단
- OpenRouter 사용 시 API 병목이 있어 Alibaba Cloud API로 전환을 선택
캡처 중복 제거 비교 실험
이 비교 실험의 pHash 해밍 거리 기준은 10, ORB 유사도 기준은 0.5입니다. 앞의 구현 기본값과 다르므로 같은 설정의 재측정 결과로 합쳐 해석하지 않습니다.
1. 개요
강의 영상에서 발표자가 슬라이드를 앞/뒤로 오가며 설명할 때 발생하는 중복 슬라이드 저장 문제를 해결하는 최적화입니다.
2. manifest.json 구조 비교
이전 버전 - 단일 시간 범위
1
2
3
4
5
6
{
  "file_name": "sample4_002_10604_85002.jpg",
  "start_ms": 10604,
  "end_ms": 85002,
  "id": "cap_002"
}
새 버전 - 다중 시간 범위 + 정보량 점수
1
2
3
4
5
6
7
8
9
10
11
{
  "file_name": "sample4_002.jpg",
  "time_ranges": [
    {"start_ms": 10604, "end_ms": 21167},
    {"start_ms": 21167, "end_ms": 85002},
    {"start_ms": 90972, "end_ms": 129090},
    {"start_ms": 159860, "end_ms": 208081}
  ],
  "info_score": 0.62,
  "id": "cap_002"
}
3. 수치 비교
| 항목 | 이전 | 새 버전 | 개선율 |
|---|---|---|---|
| 저장 이미지 수 | 11개 | 5개 | -55% |
| VLM API 호출 | 11회 | 5회 | -55% |
| 중복 슬라이드 | 6개 | 0개 | -100% |
4. 타임라인 비교 (ms 기준)
이전 버전 - 11개 이미지
1
2
3
4
5
6
7
8
9
10
0ms                                                           376,333ms
├──────────────────────────────────────────────────────────────────────┤
│ [001]  [002 ──────────────]  [003] [004][005 ────] [006] [007 ──]    │
│ 41~    10,604~85,002         85k~  91k~ 94k~       129k~ 132k~       │
│ 10,604                       91k   94k  129k       132k  160k        │
├──────────────────────────────────────────────────────────────────────┤
│ [008 ────────] [009 ──] [010 ────────────────────────────] [011]     │
│ 159,860~       208k~    226,910~376,166                    376k~     │
│ 208,081        227k                                        376k      │
└──────────────────────────────────────────────────────────────────────┘
새 버전 - 5개 이미지 (time_ranges 통합)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
0ms                                                           376,333ms
├──────────────────────────────────────────────────────────────────────┤
│ 🟢 001.jpg ─ [41 ~ 10,604]                                           │
│                                                                      │
│ 🔵 002.jpg (슬라이드A) ─┬─ [10,604 ~ 21,167]                          │
│                        ├─ [21,167 ~ 85,002]                          │
│                        ├─ [90,972 ~ 129,090]                         │
│                        └─ [159,860 ~ 208,081]                        │
│                                                                      │
│ 🟡 004.jpg (슬라이드B) ─┬─ [85,002 ~ 90,972]                          │
│                        ├─ [132,305 ~ 159,860]                        │
│                        └─ [208,081 ~ 226,910]                        │
│                                                                      │
│ 🟠 006.jpg (슬라이드C) ─┬─ [129,090 ~ 132,305]                        │
│                        └─ [226,910 ~ 376,166]                        │
│                                                                      │
│ 🔴 011.jpg ─ [376,166 ~ 376,333]                                     │
└──────────────────────────────────────────────────────────────────────┘
5. 핵심 알고리즘
중복 제거 파이프라인
1
2
3
4
5
6
7
8
9
10
11
12
13
14
┌─────────────────────────────────────────────────────────────┐
│ 1. 전환 감지 → 슬라이드 후보 추출                              │
│                                                              │
│ 2. pHash 계산 (DCT 기반 64비트 해시)                          │
│    └─ 해밍 거리 ≤ 10 → 유사 후보                              │
│                                                              │
│ 3. ORB 상세 비교 (최근 5장 + pHash 후보)                      │
│    ├─ 유사도 ≥ 0.5 → 중복 판정                                │
│    │   └─ time_ranges에 시간 추가                            │
│    │   └─ info_score 비교 → 대표 이미지 교체 여부              │
│    └─ 유사도 < 0.5 → 새 슬라이드 저장                         │
│                                                              │
│ 4. 최종 출력: file_name + time_ranges[] + info_score         │
└─────────────────────────────────────────────────────────────┘
info_score 계산 로직
1
info_score = 0.6 × ORB 특징점 정규화 + 0.4 × 엣지 밀도
| 요소 | 계산 방법 | 의미 |
|---|---|---|
| ORB 특징점 정규화 | min(특징점 수 / 500, 1.0) | 이미지 내 텍스트/도형 복잡도 |
| 엣지 밀도 | Canny 에지 픽셀 수 / 전체 픽셀 수 | 경계선 풍부도 |
목적: 중복 슬라이드 중 정보량이 더 높은 이미지를 대표로 선택
6. 병합 동작 확인
해당 실행에서는 후속 캡처 6건을 기존 슬라이드에 병합했습니다. 재등장한 슬라이드를 별도 이미지로 계속 저장하지 않고 기존 대표 이미지에 연결하는 동작을 확인한 결과입니다.
병합 후의 시간 범위는 위의 타임라인과 time_ranges 예시에서 확인할 수 있습니다. 다만 첫 번째 슬라이드가 별도로 남는 문제까지 해결된 것은 아닙니다. 이 제한은 다음 절에 정리했습니다.
7. 알려진 이슈
첫 번째 슬라이드 미병합 문제
현상: 육안으로 [001, 002, 004, 008]이 동일 슬라이드로 보이지만, 001이 별도로 저장됨
원인: Delayed Save 구조에서 첫 슬라이드 저장 시 비교 대상(history)이 비어있어 무조건 새로 저장
해결 방안 (검토 중):
- Option A: 모든 저장 완료 후 후처리로 통합
- Option B: 첫 슬라이드를 나중에 재비교
- Option C: 임계값 조정
Fusion, Summarizer, Judge에 미치는 영향
캡처와 VLM은 앞단 작업처럼 보이지만 실제로는 전체 품질에 영향을 준다.
| 앞단 품질 | downstream 영향 |
|---|---|
| 중복 캡처 감소 | VLM 비용과 처리 시간 감소 |
| 정확한 slide timeline | STT와 화면 근거 결합 품질 개선 |
| 구조화된 VLM 출력 | Summarizer 입력 품질 개선 |
| main/aux 분리 | Judge가 근거성을 보기 쉬워짐 |
멀티모달 서비스에서 좋은 요약은 마지막 LLM prompt만으로 만들어지지 않는다. 어떤 화면을 캡처했고, 어떤 정보를 VLM이 추출했으며, 그 정보가 어떤 음성 설명과 결합됐는지가 먼저 결정한다.
Capture (src/capture) 개발 이력
| Date/Phase | Change Bundle | Category | Evidence | Impact |
|---|---|---|---|---|
| 01/02 | 픽셀 차이 기반 알고리즘 | Reliability | bc40b6a | 초기 캡처 로직 구현 |
| 01/07 | Manifest.json, VLM 분석용 표준 JSON 스키마 정립 | DevEx | 1aa8250 | VLM/Judge 단계와의 데이터 계약(Contract) 수립 |
| 01/12 | Delayed Save 2.5초 대기, 최적 프레임 저장 | Quality | 4263878 | 마우스 커서, 화면 전환 노이즈로 인한 오탐지 대폭 감소 |
| 01/16 | 모듈 독립 및 설정 구조 | DevEx | c12caa9 | 캡처 엔진의 독립적 테스트 및 파라미터 튜닝 용이성 확보 |
| 01/23 | pHash+ORB 구조적 특징점 매칭 알고리즘 | Cost/Perf | bdfe9e0 | 핵심 전환점: 픽셀 단위 비교에서 의미론적 슬라이드 비교로 전환 |
| 01/23 | 슬라이드 중복 제거 최적화 구현 | Quality | bdfe9e0 | 슬라이드 내 미세 움직임 무시 및 처리 속도 향상 (비용 50% 절감) |
| 01/24 | 불연속 구간 병합 로직 | Accuracy | 4a6aee4 | 동일 슬라이드가 반복 등장해도 하나의 그룹(time_ranges)으로 묶어 데이터 정합성 확보 |
| 01/29 | Audio/Capture 병렬 실행 안정화 | Perf | f844277 | 전처리 소요 시간 단축 6분 영상(12.2s → 9.0s) |
VLM (src/vlm) 개발 이력
| Date | Change Bundle | Category | Evidence | Impact |
|---|---|---|---|---|
| 12/31 | 여러 이미지를 배치로 묶어 처리(Batch Mode) | Perf | 66c8da9 | API 호출 효율 개선 기반 |
| 01/10 | ThreadPoolExecutor로 배치 단위 병렬 요청 | Perf | 11c4a7a | VLM 수집 속도 개선 |
| 01/11~01/12 | 병렬 로그 가시화(PR #57) + 프롬프트 버전 관리(PR #61) | DevEx/Reliability | PR #57 PR #61 | 운영/디버깅 용이 |
| 01/15 | 다중 API 키 round-robin 운영 | Reliability | 5ae8b1d | 키 실패/한도 시 자동 전환 |
| 01/17 | 환각 감소 프롬프트 튜닝(표 행/열 오류, 객체 오인식 등) | Quality | Issue #76 ee0d0c2 | 동일 속도 유지하며 결과 개선 |
| 01/22~01/23 | LaTeX/Unicode/HTML 출력 금지(plain text) + 영어화(PR #115) | Reliability/Cost | PR #115 84ece67 | 토큰 장당 1077→1005(-6.7%) |
| 01/27~01/29 | OpenRouter 병목 대응: Alibaba Cloud API로 전환 + RR 유지 | Reliability/Perf | PR #137 | API 병목 완화, 운영 안정성 상승 |
남은 한계
이 개선에도 한계가 있다. 슬라이드형 강의, 코딩형 강의, 판서형 강의는 화면 변화 패턴이 다르다. OCR-first도 텍스트 중심 화면에서는 유리하지만, 도표와 복합 레이아웃에서는 VLM이 필요하다. 따라서 이 구조는 모든 강의 유형에서 동일 성능을 보장하는 방식이 아니라, 입력량과 품질을 관리하기 위한 설계로 보는 것이 맞다.
다음 글에서는 이렇게 만들어진 입력이 긴 영상 처리에서 어떤 병목을 만들고, 비동기 파이프라인으로 어떻게 다뤘는지 정리한다.